[모두의 플리] 콘텐츠 10만 건으로 조회 성능 병목 찾고 개선하기
[모두의 플리] 콘텐츠 10만 건으로 조회 성능 병목 찾고 개선하기
왜 10만 건으로 검증했을까
기능 테스트가 통과해도 데이터가 수십 건뿐이면 조회 쿼리의 병목이 잘 드러나지 않는다.
콘텐츠 검색에는 제목·설명 키워드, 타입과 태그 필터, 최신순·평점순·시청자순 정렬, 커서 페이지네이션과 전체 개수 조회가 함께 사용된다. 데이터가 늘어나면 이 조건들이 서로 영향을 주기 때문에 실제와 비슷한 규모에서 측정할 필요가 있었다.
공용 DB나 배포 환경을 오염시키지 않도록 전용 Docker PostgreSQL과 Redis를 사용했다.
| 데이터 | 건수 |
|---|---|
| 콘텐츠 | 100,000건 |
| 콘텐츠 태그 | 300,000건 |
| 리뷰 | 300,000건 |
| 시청 세션 | 20,000건 |
API는 시나리오별로 100회 요청하고 동시 작업자 10명을 두어 p95 응답 시간을 비교했다. 평균값만 보면 일부 느린 요청이 감춰질 수 있기 때문에 요청의 95%가 이 시간 안에 끝나는 p95를 함께 확인했다.
먼저 측정하고 나서 수정하기
처음부터 인덱스를 추가하지 않고 다음 순서로 진행했다.
대용량 데이터 생성
-> API 기준선 측정
-> 실제 실행 쿼리와 실행 계획 확인
-> 병목 하나씩 개선
-> 동일한 조건으로 재측정
-> 효과가 확인된 변경만 채택
이 과정에서 가장 큰 병목은 제목·설명 부분 검색이었다. 목록 쿼리의 불필요한 DISTINCT, 커서 조건의 OR 조합, totalCount 집계도 함께 점검했다.
태그 조회에서 불필요한 DISTINCT 제거
태그를 조인하면 하나의 콘텐츠가 태그 수만큼 중복될 수 있다. 초기에는 중복을 막기 위해 목록 쿼리에 DISTINCT, 개수 쿼리에 COUNT(DISTINCT ...)를 사용했다.
하지만 현재 태그 조건은 조인 결과를 직접 반환하는 방식이 아니라, 조건에 맞는 태그가 존재하는지만 검사한다. 조회의 루트는 계속 Content이므로 콘텐츠 행이 중복되지 않았다.
따라서 다음처럼 단순화할 수 있었다.
목록: DISTINCT 제거
개수: COUNT(DISTINCT content.id) -> COUNT(content.id)
태그 조건: EXISTS 성격의 any().in(tags) 유지
여러 태그가 동시에 일치하더라도 콘텐츠가 한 번만 집계되는 회귀 테스트를 추가해 최적화가 결과 정확도를 바꾸지 않는지 확인했다.
커서 조건을 튜플 비교로 변경
같은 생성 시각이나 같은 평점을 가진 콘텐츠가 여러 개라면 정렬 값 하나만으로 다음 페이지를 구분할 수 없다. 그래서 정렬 값과 UUID를 함께 커서로 사용한다.
기존 OR 조건은 다음 의미였다.
createdAt < cursorCreatedAt
OR (createdAt = cursorCreatedAt AND id < idAfter)
PostgreSQL에서는 이를 행 값 비교로 표현할 수 있다.
(created_at, id) < (:cursorCreatedAt, :idAfter)
평점순도 (average_rating, id)를 같은 방식으로 비교했다. 복합 인덱스의 정렬 순서와 쿼리의 시작 위치가 정확히 맞아 깊은 페이지에서도 인덱스를 활용하기 쉬워진다.
오름차순·내림차순과 동일한 정렬값을 가진 데이터에서 중복이나 누락이 없는지 별도로 검증했다.
부분 검색과 B-Tree 인덱스의 한계
제목과 설명은 다음과 같은 포함 검색을 사용한다.
lower(title) LIKE '%keyword%'
OR lower(description) LIKE '%keyword%'
검색어 앞에 %가 붙으면 일반 B-Tree 인덱스는 시작 위치를 알 수 없어 효율적으로 사용하기 어렵다.
PostgreSQL의 pg_trgm은 문자열을 세 글자 단위로 나누어 GIN 인덱스에서 부분 검색을 지원한다. 기존 마이그레이션을 수정하지 않고 새 마이그레이션으로 확장했다.
CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE INDEX idx_contents_title_trgm
    ON contents USING gin (lower(title) gin_trgm_ops);

CREATE INDEX idx_contents_description_trgm
    ON contents USING gin (lower(description) gin_trgm_ops);
왜 짧은 검색어는 별도로 처리했을까
Trigram은 세 글자 조각을 기준으로 동작한다. 한두 글자 검색어에는 인덱스 효과가 제한적이다.
그래서 검색어에 연속된 문자나 숫자가 세 글자 이상 있으면 LIKE 기반 GIN 인덱스 경로를 사용하고, 그렇지 않으면 LOCATE 계열의 안전한 검색 경로를 사용했다.
3글자 이상 검색어 -> pg_trgm GIN 인덱스 활용
1~2글자 검색어    -> LOCATE 계열 검색
%, _, ! 같은 문자가 검색어로 들어왔을 때 와일드카드로 오해되지 않는지도 테스트했다.
한두 글자 검색까지 빠르게 만들려면 pg_bigm이나 n-gram 기반 검색 엔진을 검토할 수 있다. 하지만 배포와 운영 복잡도가 커지므로 이번 범위에서는 도입하지 않았다.
개선 전후 결과
동일한 100회 동시 요청 조건에서 측정한 p95 결과다. 로컬 Docker 환경의 수치이므로 절대적인 운영 성능이 아니라 변경 전후 상대 비교에 의미가 있다.
| 시나리오 | 개선 전 p95 | 개선 후 p95 | 변화 |
|---|---|---|---|
| 최신순 | 78.169ms | 28.383ms | 63.7% 감소 |
| 영화 필터 | 70.706ms | 38.174ms | 46.0% 감소 |
| 2글자 검색 | 799.023ms | 247.665ms | 69.0% 감소 |
| 3글자 검색 | 468.841ms | 27.711ms | 94.1% 감소 |
| 태그 검색 | 103.268ms | 86.140ms | 16.6% 감소 |
| 평점순 | 55.256ms | 23.147ms | 58.1% 감소 |
| 시청자순 | 142.586ms | 94.519ms | 33.7% 감소 |
| 2글자·태그 조합 | 618.159ms | 97.468ms | 84.2% 감소 |
깊은 생성일 커서의 DB 실행 시간은 21.467ms에서 0.074ms로, 깊은 평점 커서는 17.045ms에서 0.078ms로 줄었다.
100,000건 DB에서 두 GIN 인덱스를 만드는 데 약 1.80초가 걸렸고 크기는 제목 약 3.2MB, 설명 약 4.8MB였다. 읽기 성능만 보지 않고 인덱스 생성 비용과 저장 공간도 함께 확인했다.
화면과 자동 테스트 검증
성능만 빨라지고 결과가 잘못되면 최적화라고 할 수 없다. 다음 항목을 함께 검증했다.
- 1·2·3글자 검색과 특수문자 검색
- 여러 태그가 일치할 때 중복 집계 방지
- 생성일·평점 커서의 양방향 정렬
- 동일한 정렬값에서 UUID 보조 정렬
- 10만 건 목록과 키워드 검색 화면
- 빈 DB에서 Flyway 전체 마이그레이션 적용
- 콘텐츠 도메인 전체 테스트
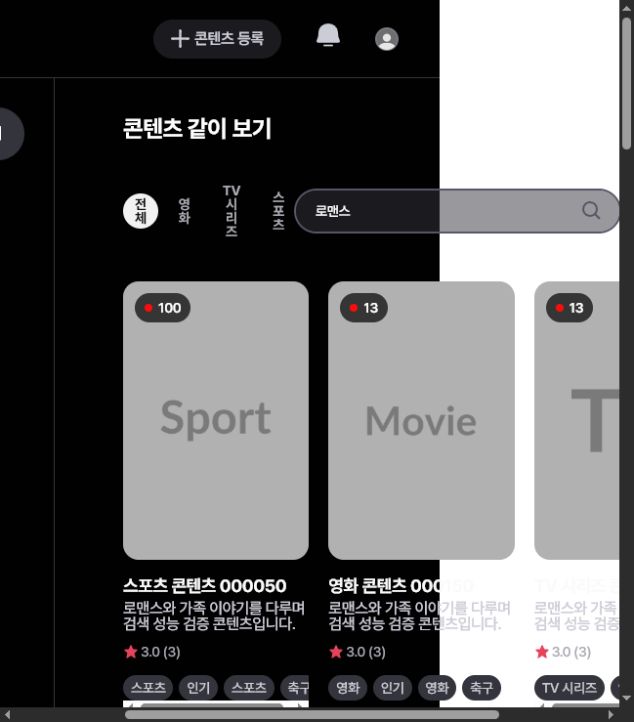
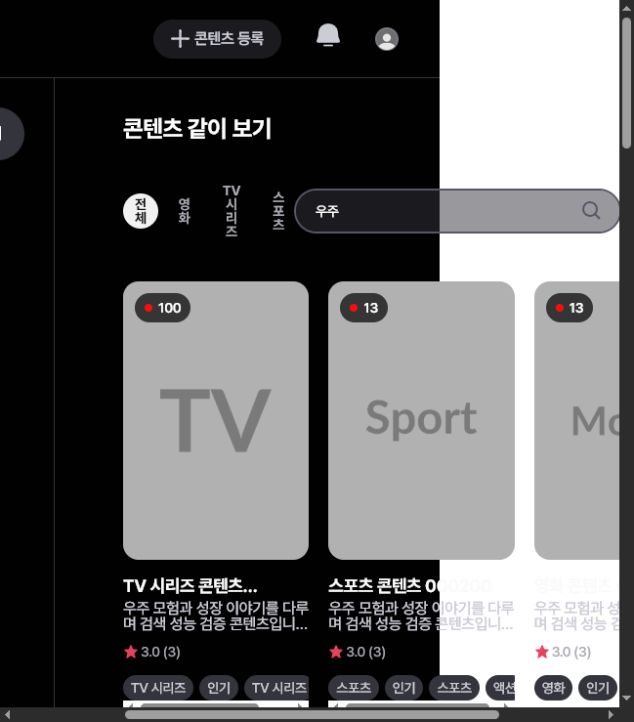
10만 건 데이터를 연결한 콘텐츠 목록 화면도 직접 확인했다.
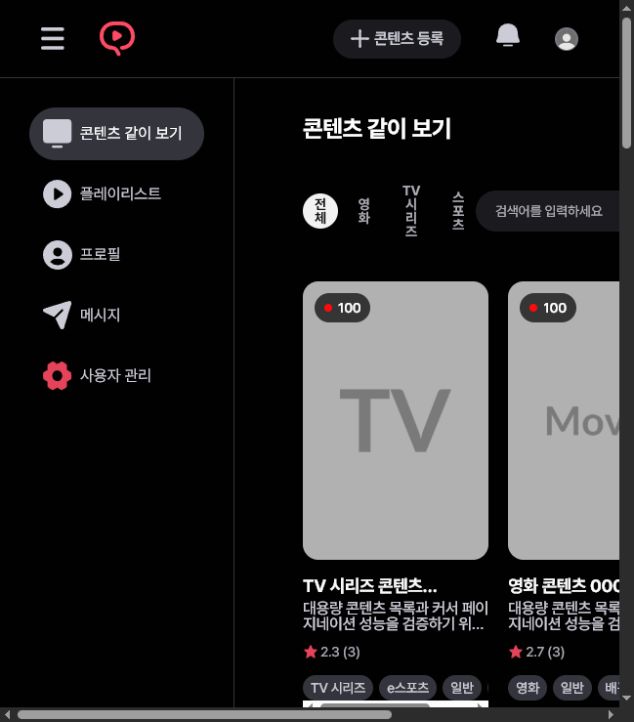
3글자 검색어인 로맨스와 2글자 검색어인 우주가 서로 다른 검색 경로에서도 정상 결과를 반환하는지 확인했다.
성능 실험용 데이터 생성 SQL, API 반복 측정 도구, 실행 방법과 최종 보고서도 저장소에 남겼다. 결과를 재현할 수 있어야 다음 변경에서도 같은 기준으로 비교할 수 있기 때문이다.
이번에 적용하지 않은 선택지
시청자순 네이티브 쿼리는 DB 실행 시간은 줄었지만 QueryDSL JPA로 동일한 필터·정렬·커서를 모두 안전하게 표현하려면 변경 범위가 커졌다. 최종 API p95가 목표 범위에 들어왔기 때문에 이번에는 채택하지 않았다.
검색 조건과 totalCount 캐시도 무효화 범위가 매우 넓다. 콘텐츠·리뷰·시청 세션 변화마다 조건 캐시를 정리해야 하므로 기존 Cache-Aside 정책에 따라 목록 조건 캐시는 제외했다.
배운 점
인덱스를 많이 추가하는 것이 최적화의 정답은 아니었다.
실제 데이터와 요청 조건으로 먼저 측정하고, 쿼리 구조와 DB의 동작 방식을 확인한 뒤, 효과가 검증된 변경만 남겨야 했다. 특히 검색어 길이에 따라 같은 인덱스의 효과가 달라지고, 커서 조건의 논리적으로 같은 표현도 실행 계획에는 큰 차이를 만들 수 있다는 점을 배웠다.